Chaque page web que vous ouvrez se fabrique à deux endroits. Une partie du travail se fait dans votre navigateur, sur votre ordinateur ou votre téléphone, et une autre partie se fait sur un ordinateur distant que vous ne voyez jamais. Le front-end désigne la première, le back-end la seconde.
Les définitions courantes s'arrêtent souvent à « la partie visible » et « la partie invisible », ce qui laisse les vraies questions sans réponse. Qu'est-ce qui tourne où, avec quels langages, et comment le savoir quand on a sous les yeux un site qu'on n'a pas construit soi-même ? Si vous venez de créer un site avec l'aide d'une IA, la question devient très pratique : votre site a-t-il un back-end, et qu'est-ce que vos visiteurs peuvent lire de votre code ?
La différence entre front-end et back-end se vérifie en quelques minutes, sans rien installer : une manipulation sur Wikipédia, plus bas, montre de vos propres yeux où s'arrête l'un et où commence l'autre.
Le front-end est la partie d'un site qui s'exécute dans votre navigateur : elle est écrite en HTML, en CSS et en JavaScript, et vous pouvez en lire tout le code. Le back-end est la partie qui s'exécute sur le serveur, avec des langages comme PHP, Python ou Node.js et souvent une base de données : vous recevez le résultat de son travail, jamais son code.
Front-end et back-end : deux endroits où le code s'exécute
La meilleure façon de séparer les deux mots est de se demander où le code travaille. Un site n'est pas un objet unique : c'est un ensemble de programmes et de fichiers, et chacun s'exécute soit chez vous, soit chez celui qui publie le site.
Le front-end : ce que votre navigateur reçoit et affiche
Le front-end, c'est tout ce que votre navigateur télécharge puis transforme en page à l'écran : les textes, les boutons, les couleurs, les menus qui s'ouvrent, le formulaire qui vous signale un champ oublié. La documentation de référence du web, MDN, résume la différence entre côté client et côté serveur ainsi :
« Le code exécuté par le navigateur est connu sous le nom de code côté client (ou front-end) et se préoccupe principalement de l'apparence et du comportement des pages web affichées. »
mdn - Developpeur Mozilla
On parle de « client » parce que votre navigateur est celui qui demande les pages. Tout ce qui se passe dans la fenêtre que vous avez sous les yeux relève donc du front-end.
Le back-end : ce qui se passe sur le serveur
Le back-end s'exécute sur un serveur, c'est-à-dire un ordinateur relié en permanence à Internet, appartenant à l'entreprise qui publie le site ou loué par elle, qui attend les demandes des visiteurs et leur répond. Son rôle est de décider quoi vous envoyer : il vérifie votre mot de passe, enregistre votre commande, retrouve l'article que vous avez demandé.
Pour cela, il s'appuie le plus souvent sur une base de données, un logiciel qui range des informations (articles, comptes, produits, commandes) de façon à pouvoir les retrouver très vite. D'après cette même page, le code côté serveur se charge de « la validation des données envoyées, l'utilisation des bases de données pour stocker et récupérer des données et l'envoi de données générées au client ».
Le tableau suivant met les deux côtés face à face, sur les critères qui permettent de les reconnaître.
| Front-end | Back-end | |
|---|---|---|
| Où le code s'exécute | Dans votre navigateur | Sur le serveur du site |
| Son rôle | Afficher la page et réagir à vos gestes | Décider du contenu, enregistrer et retrouver les données |
| Langages typiques | HTML, CSS, JavaScript | PHP, Python, Ruby, C#, Java, JavaScript avec Node.js |
| Ce que vous pouvez en voir | Tout le code reçu | Seulement le résultat qu'il renvoie |
La dernière ligne est la plus utile, car c'est elle que vous allez pouvoir vérifier vous-même un peu plus loin.
Le trajet d'une page, de votre clic jusqu'à l'affichage
Les deux côtés ne travaillent pas chacun dans leur coin : ils se parlent à chaque fois que vous ouvrez une page. Ce dialogue suit toujours le même ordre, que vous visitiez un site de recettes ou votre messagerie.
- Vous tapez une adresse ou cliquez sur un lien, et votre navigateur envoie une requête au serveur, c'est-à-dire un court message qui dit « envoyez-moi cette page ».
- Le serveur reçoit la requête. Sur un site dynamique, le back-end se met alors au travail : il interroge la base de données, vérifie qui vous êtes si vous êtes connecté, puis assemble la page. Sur un site statique, le serveur renvoie simplement le fichier demandé.
- Le serveur renvoie une réponse qui contient le HTML de la page. Votre navigateur y découvre les fichiers CSS, JavaScript et les images dont la page a besoin, et les demande à leur tour.
- Le navigateur affiche la page, puis le JavaScript prend le relais pour réagir à vos clics. Quand il a besoin de nouvelles informations, il envoie lui-même une nouvelle requête au serveur, sans recharger toute la page.
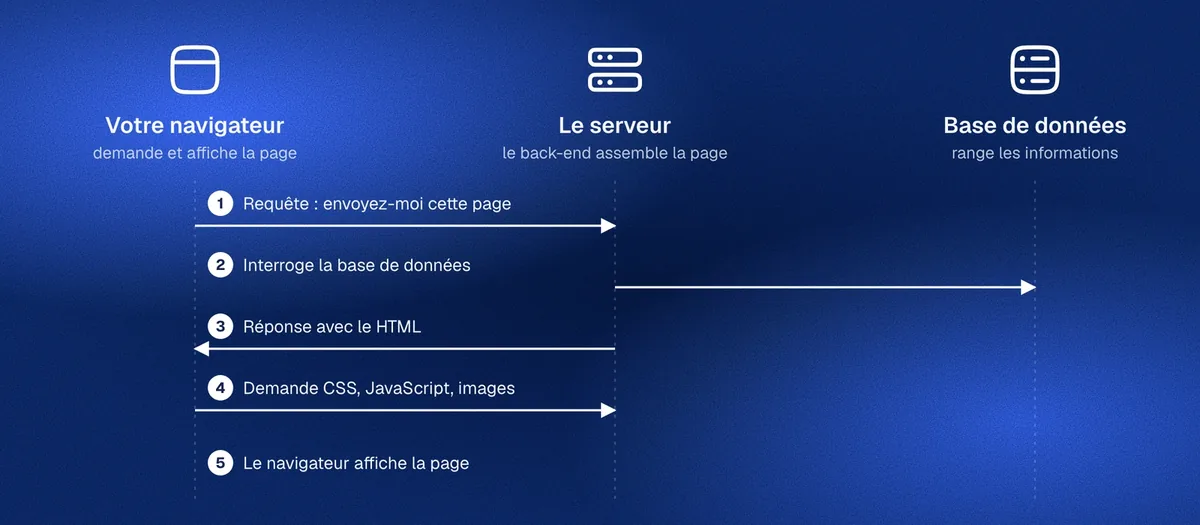
Ce trajet explique pourquoi certains sites n'ont presque pas de back-end. Un site statique est un site dont les pages sont des fichiers déjà prêts : le serveur se contente alors de renvoyer le fichier demandé, tel quel. Un site dynamique, au contraire, fabrique ses pages à la demande, en insérant dans un modèle de page les données tirées de sa base de données.
Beaucoup de sites créés avec l'aide d'une IA se présentent ainsi : un dossier de fichiers HTML, CSS et JavaScript, sans programme qui tourne sur un serveur. GitHub Pages se définit d'ailleurs comme un hébergeur de sites statiques : il met en ligne les fichiers HTML, CSS et JavaScript rangés dans un dépôt. Cela suffit pour publier un premier site pas à pas avec GitHub Pages. Dès que votre site doit enregistrer quelque chose (un compte, un message, un paiement), il lui faut en revanche un back-end. Ce peut être le vôtre, ou celui d'un service extérieur : un service de formulaires, de paiement ou de comptes utilisateurs, que le JavaScript de votre page interroge et qui garde les données sur ses propres serveurs. Pour savoir où en est votre propre site, ouvrez son dossier. S'il ne contient que des fichiers .html, .css et .js, et que vous l'avez publié en déposant ces fichiers chez un hébergeur, il n'a pas de back-end à vous : tout ce qu'il contient, vos visiteurs peuvent le lire. S'il contient un programme que l'hébergeur doit lancer, par exemple des fichiers .php ou un serveur Node.js, ce programme est votre back-end.
Les langages du front-end : HTML, CSS et JavaScript
Côté navigateur, le choix est restreint : quel que soit l'outil utilisé pour le fabriquer, un site envoie à votre navigateur du HTML, du CSS et du JavaScript. MDN décrit leur répartition en une phrase : le HTML sert à créer le contenu et la structure de la page, le CSS décrit sa présentation, et le JavaScript ajoute les fonctionnalités interactives.
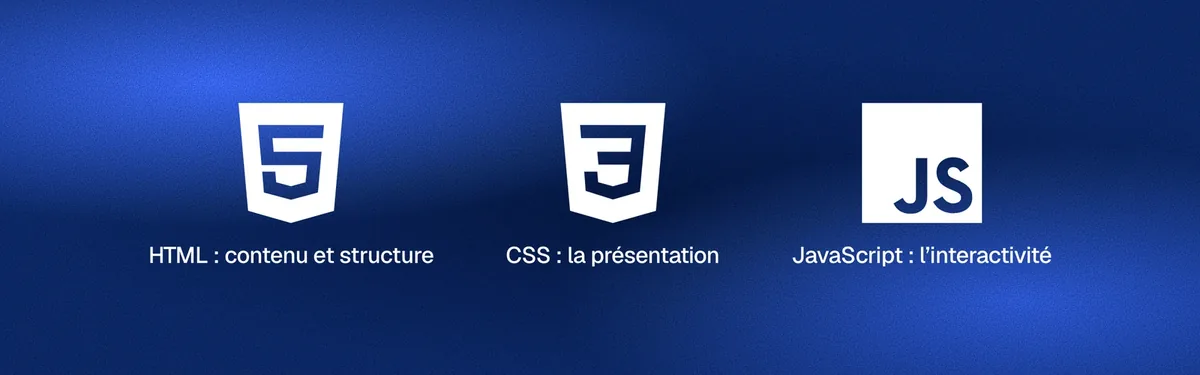
Le HTML dit ce que contient la page : ce titre est un titre, ce texte est un paragraphe, cette image vient de tel fichier. Ce n'est pas un langage de programmation au sens strict, mais un langage de balises, c'est-à-dire des étiquettes placées autour du contenu pour en indiquer la nature.
Le CSS décide de l'apparence de ce contenu : couleurs, polices, tailles, disposition sur un écran large ou sur un téléphone. Sans lui, la page affiche le même texte, mais en noir sur blanc, empilé de haut en bas.
Le JavaScript, enfin, rend la page vivante : il ouvre un menu quand vous cliquez, affiche des suggestions pendant que vous tapez, ajoute un produit au panier sans recharger la page. Vous croiserez aussi des noms comme React, présenté par ses auteurs comme une bibliothèque pour construire des interfaces utilisateur : ce sont des outils écrits en JavaScript qui aident à fabriquer le front-end, et ils ne remplacent pas ces trois langages.
Les langages et outils du back-end
Sur le serveur, le choix est beaucoup plus large, puisque c'est celui qui publie le site qui décide de ce qui tourne sur sa machine. MDN cite parmi les langages les plus utilisés côté serveur PHP, Python, Ruby, C# et Node.js. Java s'emploie lui aussi côté serveur, par exemple avec Spring, un outil conçu pour construire des applications web en Java.
Ces langages s'accompagnent souvent d'un framework, c'est-à-dire un ensemble de briques prêtes à l'emploi (gestion des comptes, accès à la base de données, création des pages) qui évite de tout réécrire à chaque projet. Django joue par exemple ce rôle pour Python, et Spring pour Java.
Node.js trouble beaucoup de débutants, car JavaScript apparaît alors des deux côtés. La documentation de Node.js explique qu'il fait tourner le moteur JavaScript de Google Chrome « en dehors du navigateur ». Le langage est le même, mais l'endroit où il s'exécute change tout : le JavaScript envoyé à votre navigateur fait partie du front-end, celui qui tourne sur le serveur fait partie du back-end.
Le point commun de tous ces langages est que leur code ne quitte jamais le serveur. Le manuel officiel de PHP le formule sans ambiguïté :
« Le client ne reçoit que le résultat du script, sans aucun moyen d'avoir accès au code qui a produit ce résultat. »
PHP - Doc Officiel
Autrement dit, le back-end travaille en amont et vous livre seulement ce qu'il a produit, c'est-à-dire du HTML, des données ou un fichier.
L'exemple à refaire sur Wikipédia : voir ce qui arrive dans votre navigateur
Tout ce qui précède se vérifie en quelques minutes, sans rien installer, sur un site que vous connaissez déjà. Wikipédia s'y prête bien, car le logiciel qui la fait fonctionner, MediaWiki, est décrit par ses développeurs comme un programme qui utilise PHP pour traiter et afficher des données stockées dans une base de données. Les étapes ci-dessous utilisent Google Chrome, mais les autres navigateurs proposent des outils très proches.
Afficher le code source de la page
Ouvrez n'importe quel article de Wikipédia, puis appuyez sur Ctrl + U sous Windows ou Linux, ou sur ⌘ + Option + U sur Mac. D'après l'aide de Chrome sur les raccourcis clavier, ce raccourci affiche le code source HTML de la page active dans un nouvel onglet.
Vous voyez alors exactement ce que le serveur vous a envoyé : du HTML, des liens vers des fichiers CSS et JavaScript, et le texte de l'article. Vous aurez beau chercher, vous n'y trouverez pas une ligne de PHP ni la moindre trace de la base de données, puisque le serveur ne vous a transmis que la page déjà assemblée.
Sur les forums, une question revient souvent : comment récupérer le code PHP d'un site en affichant son code source. La réponse est toujours la même : c'est impossible depuis le navigateur, sauf si le site publie lui-même ce code ailleurs.
Inspecter un élément dans l'onglet Éléments
Faites maintenant un clic droit sur le titre de l'article et choisissez « Inspecter ». La documentation des outils de développement de Chrome précise que cette commande ouvre le panneau Éléments directement sur l'élément choisi. Les outils de développement sont une fenêtre intégrée au navigateur qui montre tout ce que la page a reçu et tout ce qu'elle fait.
Double-cliquez sur le texte du titre dans ce panneau, remplacez-le par ce que vous voulez et appuyez sur Entrée : la page affiche aussitôt votre nouveau titre. Rechargez ensuite la page, et le titre d'origine revient. Vous venez de modifier le front-end, c'est-à-dire la copie de la page qui se trouve dans votre navigateur, alors que l'article enregistré sur le serveur n'a pas bougé.
Suivre une recherche dans l'onglet Réseau
Le dernier essai montre le dialogue entre les deux côtés pendant qu'il a lieu. L'onglet Réseau (Network si vos outils sont en anglais) liste chaque requête que la page envoie et chaque réponse qu'elle reçoit. La documentation du panneau Network rappelle qu'il n'enregistre l'activité que lorsque les outils de développement sont ouverts, d'où l'ordre des étapes :
- Sur la page d'accueil de Wikipédia, appuyez sur
F12(ou⌘+Option+Isur Mac) pour ouvrir les outils de développement. - Cliquez sur l'onglet Réseau, puis sur le filtre Fetch/XHR, qui ne garde que les requêtes envoyées par le JavaScript de la page.
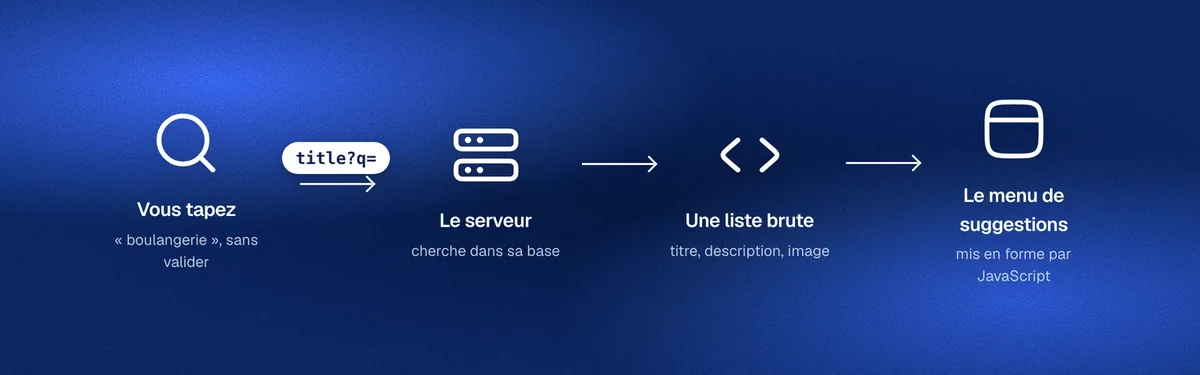
- Tapez lentement « boulangerie » dans le champ de recherche de Wikipédia, sans valider.
- Regardez les lignes qui apparaissent dans la liste : leur nom commence par
title?q=suivi des lettres que vous avez tapées. - Cliquez sur la dernière de ces lignes, puis sur l'onglet Aperçu (Preview) ou Réponse (Response).
Ce que vous voyez dans la réponse, ce sont des données brutes, sans mise en page : une liste de pages avec leur titre, une courte description (pour « Boulangerie », il s'agit de « boutique consacrée à la vente de pain ») et l'adresse d'une petite image. La documentation de MediaWiki explique que ce point d'entrée cherche les pages dont le titre commence par les mots tapés et qu'il sert aux suggestions automatiques. Ce point d'entrée fait partie de ce qu'on appelle une API, une porte prévue par le back-end pour que d'autres programmes, ici le JavaScript de la page, lui demandent des données.
La répartition des rôles est désormais visible. Le serveur a cherché dans sa base de données les titres qui correspondent à vos lettres et a renvoyé une liste brute. Le JavaScript de votre navigateur a ensuite transformé cette liste en menu de suggestions, avec ses images et sa mise en forme. Si vous choisissez enfin une suggestion avec le filtre Doc activé, vous verrez arriver la page HTML complète que le serveur a assemblée pour vous, et toujours aucune ligne de PHP.
Tout ce que votre navigateur reçoit, n'importe quel visiteur peut le lire de la même façon. Un mot de passe ou une clé d'accès à un service payant placé dans le JavaScript d'un site est donc visible de tous. OpenAI demande ainsi, dans la documentation de son API, de ne jamais exposer sa clé « in any client-side code such as browsers or apps », c'est-à-dire dans du code côté client, qu'il s'agisse d'un navigateur ou d'une application. Ce genre de secret doit rester côté serveur.
Front-end, back-end ou full stack : qui fait quoi
Cette séparation technique se retrouve dans l'organisation du travail, puisque les deux côtés demandent des savoir-faire différents. Le développeur front-end construit ce que vous voyez et manipulez : il traduit une maquette en HTML et en CSS, fait fonctionner les boutons et les formulaires en JavaScript, et vérifie que la page s'affiche bien sur un téléphone comme sur un grand écran.
Le développeur back-end, lui, construit ce qui tourne sur le serveur : il organise la base de données, écrit les règles du site (qui a le droit de voir quoi, ce qui se passe quand une commande est validée) et prépare les API que le front-end interroge. Son travail ne se voit pas à l'écran, mais il se remarque immédiatement quand il manque, par exemple quand un panier se vide ou qu'une connexion échoue.
Entre les deux, le développeur full stack sait travailler des deux côtés. Ce profil est courant dans les petites équipes, où une même personne doit pouvoir faire avancer une fonctionnalité de la base de données jusqu'au bouton. Aucun des deux côtés ne fonctionne seul : un front-end sans back-end ne peut rien enregistrer, et un back-end sans front-end n'a personne à qui montrer ses résultats.
Si vous hésitez sur la voie à prendre, le front-end a un avantage pour débuter : vous voyez immédiatement le résultat de chaque ligne écrite, avec un simple navigateur. Le back-end attire davantage ceux qui aiment organiser des données et comprendre comment un système tient debout. Dans les deux cas, HTML, CSS et un peu de JavaScript restent la base commune, car même un développeur back-end doit comprendre ce que son serveur envoie au navigateur.
Ce que votre navigateur reçoit, c'est le front-end
La différence entre front-end et back-end tient finalement à une question simple : où ce code s'exécute-t-il ? Ce qui arrive dans votre navigateur, et que vous pouvez lire avec le code source ou les outils de développement, forme le front-end. Ce qui reste sur le serveur et ne vous parvient que sous forme de résultat forme le back-end. Une fois cette frontière repérée sur Wikipédia, vous la reconnaîtrez sur n'importe quel site, y compris le vôtre.